نماذج التحول (Transformers) وآليات الانتباه الذاتي: الثورة خلف النماذج اللغوية
دراسة رياضية لبنية Multi-Head Attention وتحليل ورقة Attention Is All You Need.
المقدمة
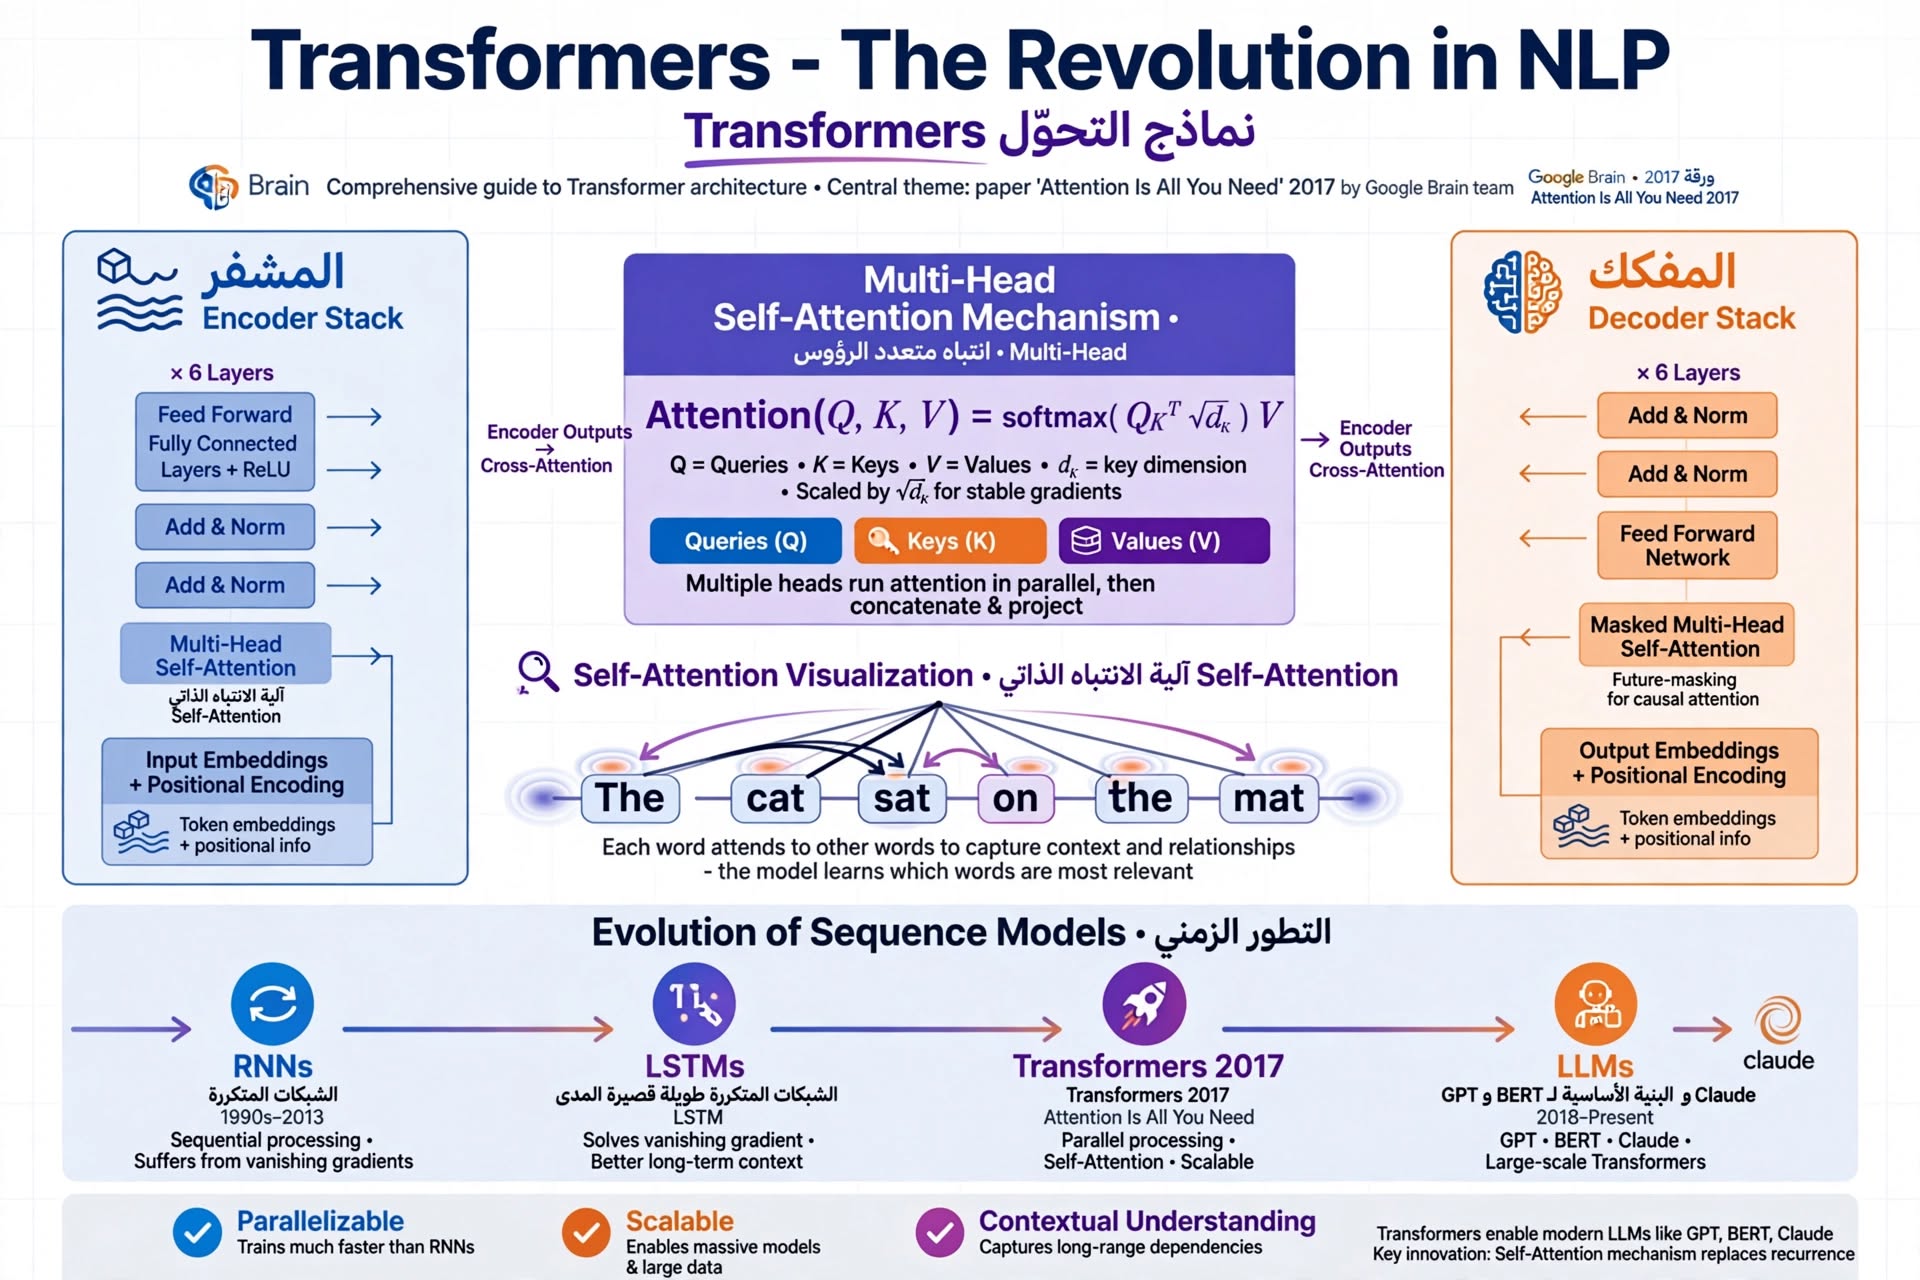
تُمثّل نماذج التحوّل (Transformers) المرتكزة على آليات الانتباه الذاتي (Self-Attention) القفزة العلمية الأهم في تاريخ معالجة اللغات الطبيعية (NLP) والذكاء الاصطناعي التوليدي. فمنذ تقديمها في الورقة البحثية التاريخية "Attention Is All You Need" عام 2017 بواسطة فريق بحثي من Google Brain، أزاحت هذه المعمارية الشبكات العصبية المتكررة (RNNs) وشبكات الذاكرة الطويلة قصيرة المدى (LSTMs) لتصبح البنية التحتية الأساسية لكافة النماذج اللغوية الضخمة المعاصرة مثل GPT وBERT وClaude.
1. المعضلات البنيوية في النماذج التقليدية (ما قبل عهد الـ Transformer)
قبل عام 2017، اعتمدت معالجة النصوص على الشبكات المتكررة (Recurrent Neural Networks) التي تعالج الكلمات بشكل تسلسلي خطي (Word-by-Word). خلقت هذه الآلية عائقين علميين جسيمين:
• مشكلة التلاشي والانفجار للمنحدر الرقمي (Vanishing/Exploding Gradients): عند التعامل مع نصوص طويلة، تضعف الروابط الرياضية بين الكلمات الأولى والكلمات الأخيرة، مما يفقد النموذج القدرة على ربط سياق الجمل البعيدة.
• غياب التوازي الحسابي (Lack of Parallelization): ظراً لأن معالجة الكلمة الحالية تعتمد كلياً على مخرجات الكلمة السابقة، استحال تدريب هذه النماذج بالتوازي على معالجات الرسوميات (GPUs)، مما وضع سقفاً منخفضاً لحجم البيانات التي يمكن التدرب عليها.
2. آلية الانتباه الذاتي (Self-Attention Mechanism): الصياغة الرياضية
تكمن عبقرية الـ Transformer في التخلي التام عن التكرار التسلسلي واستبداله بآلية الانتباه الذاتي الرياضي، والتي تسمح للنموذج بتقييم العلاقة والارتباط بين كل كلمة وأي كلمة أخرى داخل النص في نفس الوقت بغض النظر عن المسافة بينهما.
تتم العملية الحسابية من خلال تحويل كل كلمة (بعد تحويلها إلى مُتجه عددي Embedding) إلى ثلاثة مصفوفات أساسية عبر أوزان يتم تعلمها أثناء التدريب:
• مُتجه الاستعلام (Query - Q): يُمثّل الكلمة الحالية التي تبحث عن سياقها.
• مُتجه المفتاح (Key - K): يُمثّل كافة الكلمات في النص لتقييم مدى صلتها بالاستعلام.
• مُتجه القيمة (Value - V): يحتوي على المعلومات الفعلية للكلمة والتي ستُدمج في المخرج النهائي بناءً على أوزان الانتباه.
قانون الانتباه الذاتي القياسي (Scaled Dot-Product Attention) تُحسب الأوزان وتُدمج عبر المعادلة المصفوفية التالية:
• حيث إن QKT هو الضرب النقطي لقياس درجة التشابه والسياق بين الاستعلام والمفاتيح.
• المعامل√dk (جذر أبعاد متجهات المفاتيح) يُستخدم كعامل تحجيم (Scaling) لمنع تضخم القيم الحسابية التي تؤدي إلى ثبات مشتقة دالة الـ Softmax عند قيم تقترب من الصفر.
• دالة Softmax تحوّل المخرجات إلى نسب مئوية (أوزان احتمالية) مجموعها يساوي 1.
3. الانتباه الذاتي متعدد الرؤوس (Multi-Head Attention)
بدلاً من حساب الانتباه مرة واحدة للمصفوفة كاملة، يَقسم الـ Transformer المتجهات إلى "رؤوس" متعددة (Heads) تعمل بالتوازي.
• تتيح هذه الطريقة للنموذج التركيز على جوانب سياقية مختلفة في آن واحد.
• على سبيل المثال: في جملة "أكلت القطة الفأر لأنها كانت جائعة"، يستطيع رأس انتباه واحد ربط الضمير "ها" بـ "القطة" (علاقة نحوية)، بينما يربط رأس آخر "جائعة" بـ "أكلت" (علاقة دلالية).
4. المكونات الساندة في معمارية المحولات
إلى جانب الانتباه الذاتي، تتكامل المعمارية عبر طبقات هندسية محكمة لضمان الاستقرار الحسابي:
• الترميز الموضعي (Positional Encoding): بما أن النموذج يعالج النص دفعة واحدة وليس تسلسلياً، فإنه يفتقر بشكل طبيعي لمعرفة ترتيب الكلمات. يُغلّف الـ Transformer دوال جيبية وجيب تمام (Sine and Cosine functions) بترددات مختلفة تُضاف إلى متجهات الكلمات لمنح النموذج وعياً دقيقاً بالترتيب المكاني لكل كلمة.
• الروابط المتبقية والتقييس (Residual Connections & Layer Normalization): تُمرر المدخلات مباشرة حول طبقات الانتباه لتُجمع مع مخرجاتها، مما يمنع تلاشي الإشارات الحسابية ويسمح ببناء نماذج عميقة جداً تتألف من مئات الطبقات.
• لشبكات العصبية الأمامية (Feed-Forward Networks): بعد معالجة السياق عبر الانتباه، يتم تمرير مخرجات كل كلمة بشكل مستقل عبر شبكة عصبية كثيفة ومعيارية لإضافة خطية غير 선ية (Non-linearity) وتعزيز القوة التعبيرية للنموذج.
5. كيف أحدثت المحولات ثورة في النماذج اللغوية (LLMs)؟
فتحت معمارية الـ Transformer الباب على مصراعيه لظهور الذكاء الاصطناعي التوليدي عبر ركيزتين:
1. الكفاءة الحسابية الهائلة لـ GPUs: بفضل المعالجة المتوازية، أصبح من الممكن تدريب النماذج على كامل بيانت الإنترنت (مليارات النصوص) في فترات زمنية معقولة.
2. التعلم المستند إلى السياق الفائق:استطاعت النماذج فهم الفروق الدقيقة، التناقضات، المراجع البعيدة، وحتى إنتاج نصوص برمجية وأدبية بجودة تضاهي البشر.
انقسمت النماذج لاحقاً بناءً على أجزاء المعمارية:
• نماذج الترميز فقط (Encoder-only): مثل BERT، وتُركز على فهم النصوص وتحليل المشاعر.
• نماذج التوليد فقط (Decoder-only): • مثل سلسلة عائلة GPT، وتعتمد على التنبؤ بالكلمة التالية وتوليد المحتوى الإبداعي والمحادثات.
خاتمة وآفاق مستقبلية
أثبتت نماذج التحول (Transformers) أنها ليست مجرد أداة لمعالجة الكلمات، بل هي أسلوب صياغة رياضي قادر على نمذجة العلاقات المعقدة في شتى أنواع البيانات؛ حيث تم تكييفها بنجاح لمعالجة الرؤية الحاسوبية (Vision Transformers - ViTs)، وفي الكيمياء الحيوية للتنبؤ بطي البروتينات (AlphaFold). وتبقى آلية الانتباه الذاتي حجر الزاوية العلمي الذي نقل الآلات من مرحلة حفظ الإحصاءات البليدة إلى مرحلة الفهم السياقي العميق والتوليد الابتكاري الفائق.