التعلم الآلي على الحافة (Edge AI): تقنيات ضغط النماذج Quantization & Pruning
كيفية تقليص حجم النماذج العصبية لتشغيلها على الشرائح المدمجة والهواتف كفؤاً.
المقدمة
تعد تقنية التعلم الآلي على الحافة (Edge AI) واحدة من أهم القفزات التقنية في مجال الحوسبة الموزعة والذكاء الاصطناعي. تهدف هذه التقنية إلى تشغيل نماذج التعلم العميق (Deep Learning) مباشرة على الأجهزة الطرفية (مثل الهواتف الذكية، الحواسب المدمجة، وأجهزة IoT) دون الحاجة للاعتماد الدائم على خوادم الحوسبة السحابية المركزية.
ومع ذلك، تواجه هذه الطفرة عقبة بنيوية؛ فنماذج التعلم العميق الحديثة (مثل الشبكات العصبية العميقة CNNs ونماذج المحولات الكبيرة LLMs) تحتوي على مليارات المعلمات (Parameters) وتتطلب قدرات حسابية هائلة (Compute-intensive) ومساحات تخزينية ضخمة. في المقابل، تعاني أجهزة الحافة من قيود صارمة في الطاقة، والذاكرة العشوائية (RAM)، والقدرة على تبديد الحرارة. ومن هنا برزت الحاجة الملحة إلى تقنيات ضغط النماذج (Model Compression)، والتي تصدرتها تقنيتان رئيسيتان: الكمية (Quantization) والتقليم (Pruning)

1. تقنية تكميم النماذج (Model Quantization)
تعتمد تقنية الكمية (Quantization) على فكرة تقليل الدقة الحسابية للمعلمات (Weights) والنشاطات (Activations) داخل الشبكة العصبية. في مرحلة التدريب التقليدية، تُخزن المعلمات كأرقام عشرية ذات دقة عائمة 32-بت (FP32). تقوم عملية التكميم بتحويل هذه القيم إلى تنسيقات ذات دقة منخفضة، مثل الأرقام الصحيحة ذات 8-بت (INT8) أو حتى أقل (INT4).
الآلية الرياضية للتكميم
تتم عملية التحويل عبر دالة خطية تنقل القيم من النطاق العائم [rmin, rmax] إلى النطاق الصحيح [qmin, qmax] باستخدام صيغة التكميم القياسي
حيث أن:
• r القيمة الحقيقية الأصلية (Floating-point).
• S (Scale): عامل القياس، وهو رقم عشري يحدد حجم الخطوة.
• Z (Scale): • (Zero-point): النقطة الصفرية، وهي قيمة صحيحة تُحاذي الصفر الحقيقي في النطاق العائم.
أنواع التكميم الرئيسية
1. التكميم بعد التدريب (Post-Training Quantization - PTQ): يتم تطبيق التكميم مباشرة على نموذج مدرب بالكامل. تتميز هذه الطريقة بالسرعة وعدم حاجتها لإعادة تدريب النموذج، لكنها قد تؤدي إلى تراجع طفيف في الدقة إذا كانت توزيعات الأوزان معقدة.
2. التدريب الواعي بالتكميم (Quantization-Aware Training - QAT): يتم نمذجة أخطاء التكميم خلال مرحلة التدريب نفسها باستخدام "تكميم وهمي" (Fake Quantization). يتنبه النموذج لتقليل الدقة ويقوم بتعديل الأوزان للتكيف معها، مما يحافظ على دقة النموذج الأصلية بشكل شبه كامل عند تحويله النهائي إلى INT8.
2.تقنية تقليم النماذج (Model Pruning)
تستند تقنية التقليم (Pruning) إلى حقيقة علمية مفادها أن الشبكات العصبية العميقة تعاني من "الإفراط في التخصيص" (Over-parameterization)، مما يعني أن عدداً كبيراً من المعلمات والروابط بين العصبونات تكون قيمها قريبة من الصفر ولا تساهم بفعالية في اتخاذ القرار. تهدف عملية التقليم إلى حذف هذه الروابط أو العصبونات غير المؤثرة لتقليل حجم النموذج وتسريع الاستنتاج.


استراتيجيات التقليم
تنقسم عملية التقليم إلى منهجين أساسيين بناءً على الهيكلية الناتجة:
• التقليم غير المهيكل (Unstructured Pruning): يتم فيه حذف الأوزان الفردية بناءً على قيمتها المطلقة (على سبيل المثال، حذف أي وزن يقترب من الصفر). ينتج عن ذلك مصفوفات ذات أوزان متباعدة (Sparse Matrices). ورغم أنه يحافظ على دقة النموذج بشكل ممتاز، إلا أنه يتطلب برمجيات وأجهزة مخصصة (تعتمد على الحوسبة المتناثرة) للاستفادة الفعالة من تسريع الأداء.
• التقليم المهيكل (Structured Pruning): يتم فيه حذف قنوات كاملة (Channels)، أو عصبونات كاملة (Neurons)، أو طبقات بأكملها. ينتج عن هذا التقليم مصفوفات أصغر حجماً ومنتظمة، مما يسمح بتسريع الأداء المباشر على جميع المعالجات التقليدية (CPUs و GPUs) دون الحاجة لدعم خاص للحوسبة المتناثرة.
مقارنة تحليلية بين التكميم والتقليم
| وجه المقارنة | تكميم النماذج (Quantization) | تقليم النماذج (Pruning) |
|---|---|---|
| الفكرة الأساسية | تقليل عدد البتات المستخدمة لتمثيل كل وزن | حذف المعلمات والروابط غير الضرورية تماماً |
| التأثير على البنية | تظل بنية الشبكة كما هي دون تغيير في عدد المعلمات | تتغير بنية الشبكة وتصبح المصفوفات أصغر أو متناثرة |
| مكاسب الذاكرة | تقليص الحجم بمقدار ثابت (مثلاً من 32-بت إلى 8-بت يقلل الحجم بـ 4 مرات) | يعتمد على نسبة التقليم (يمكن حذف 50% إلى 90% من المعلمات) |
| تسريع الاستنتاج | كبير جداً، لأن معالجة INT8 أسرع بكثير من FP32 على معالجات الحافة | يعتمد على نوع التقليم (المهيكل يوفر تسريعاً مباشراً، غير المهيكل يحتاج دعم برامجي) |
التكامل الهندسي والأثر التطبيقي
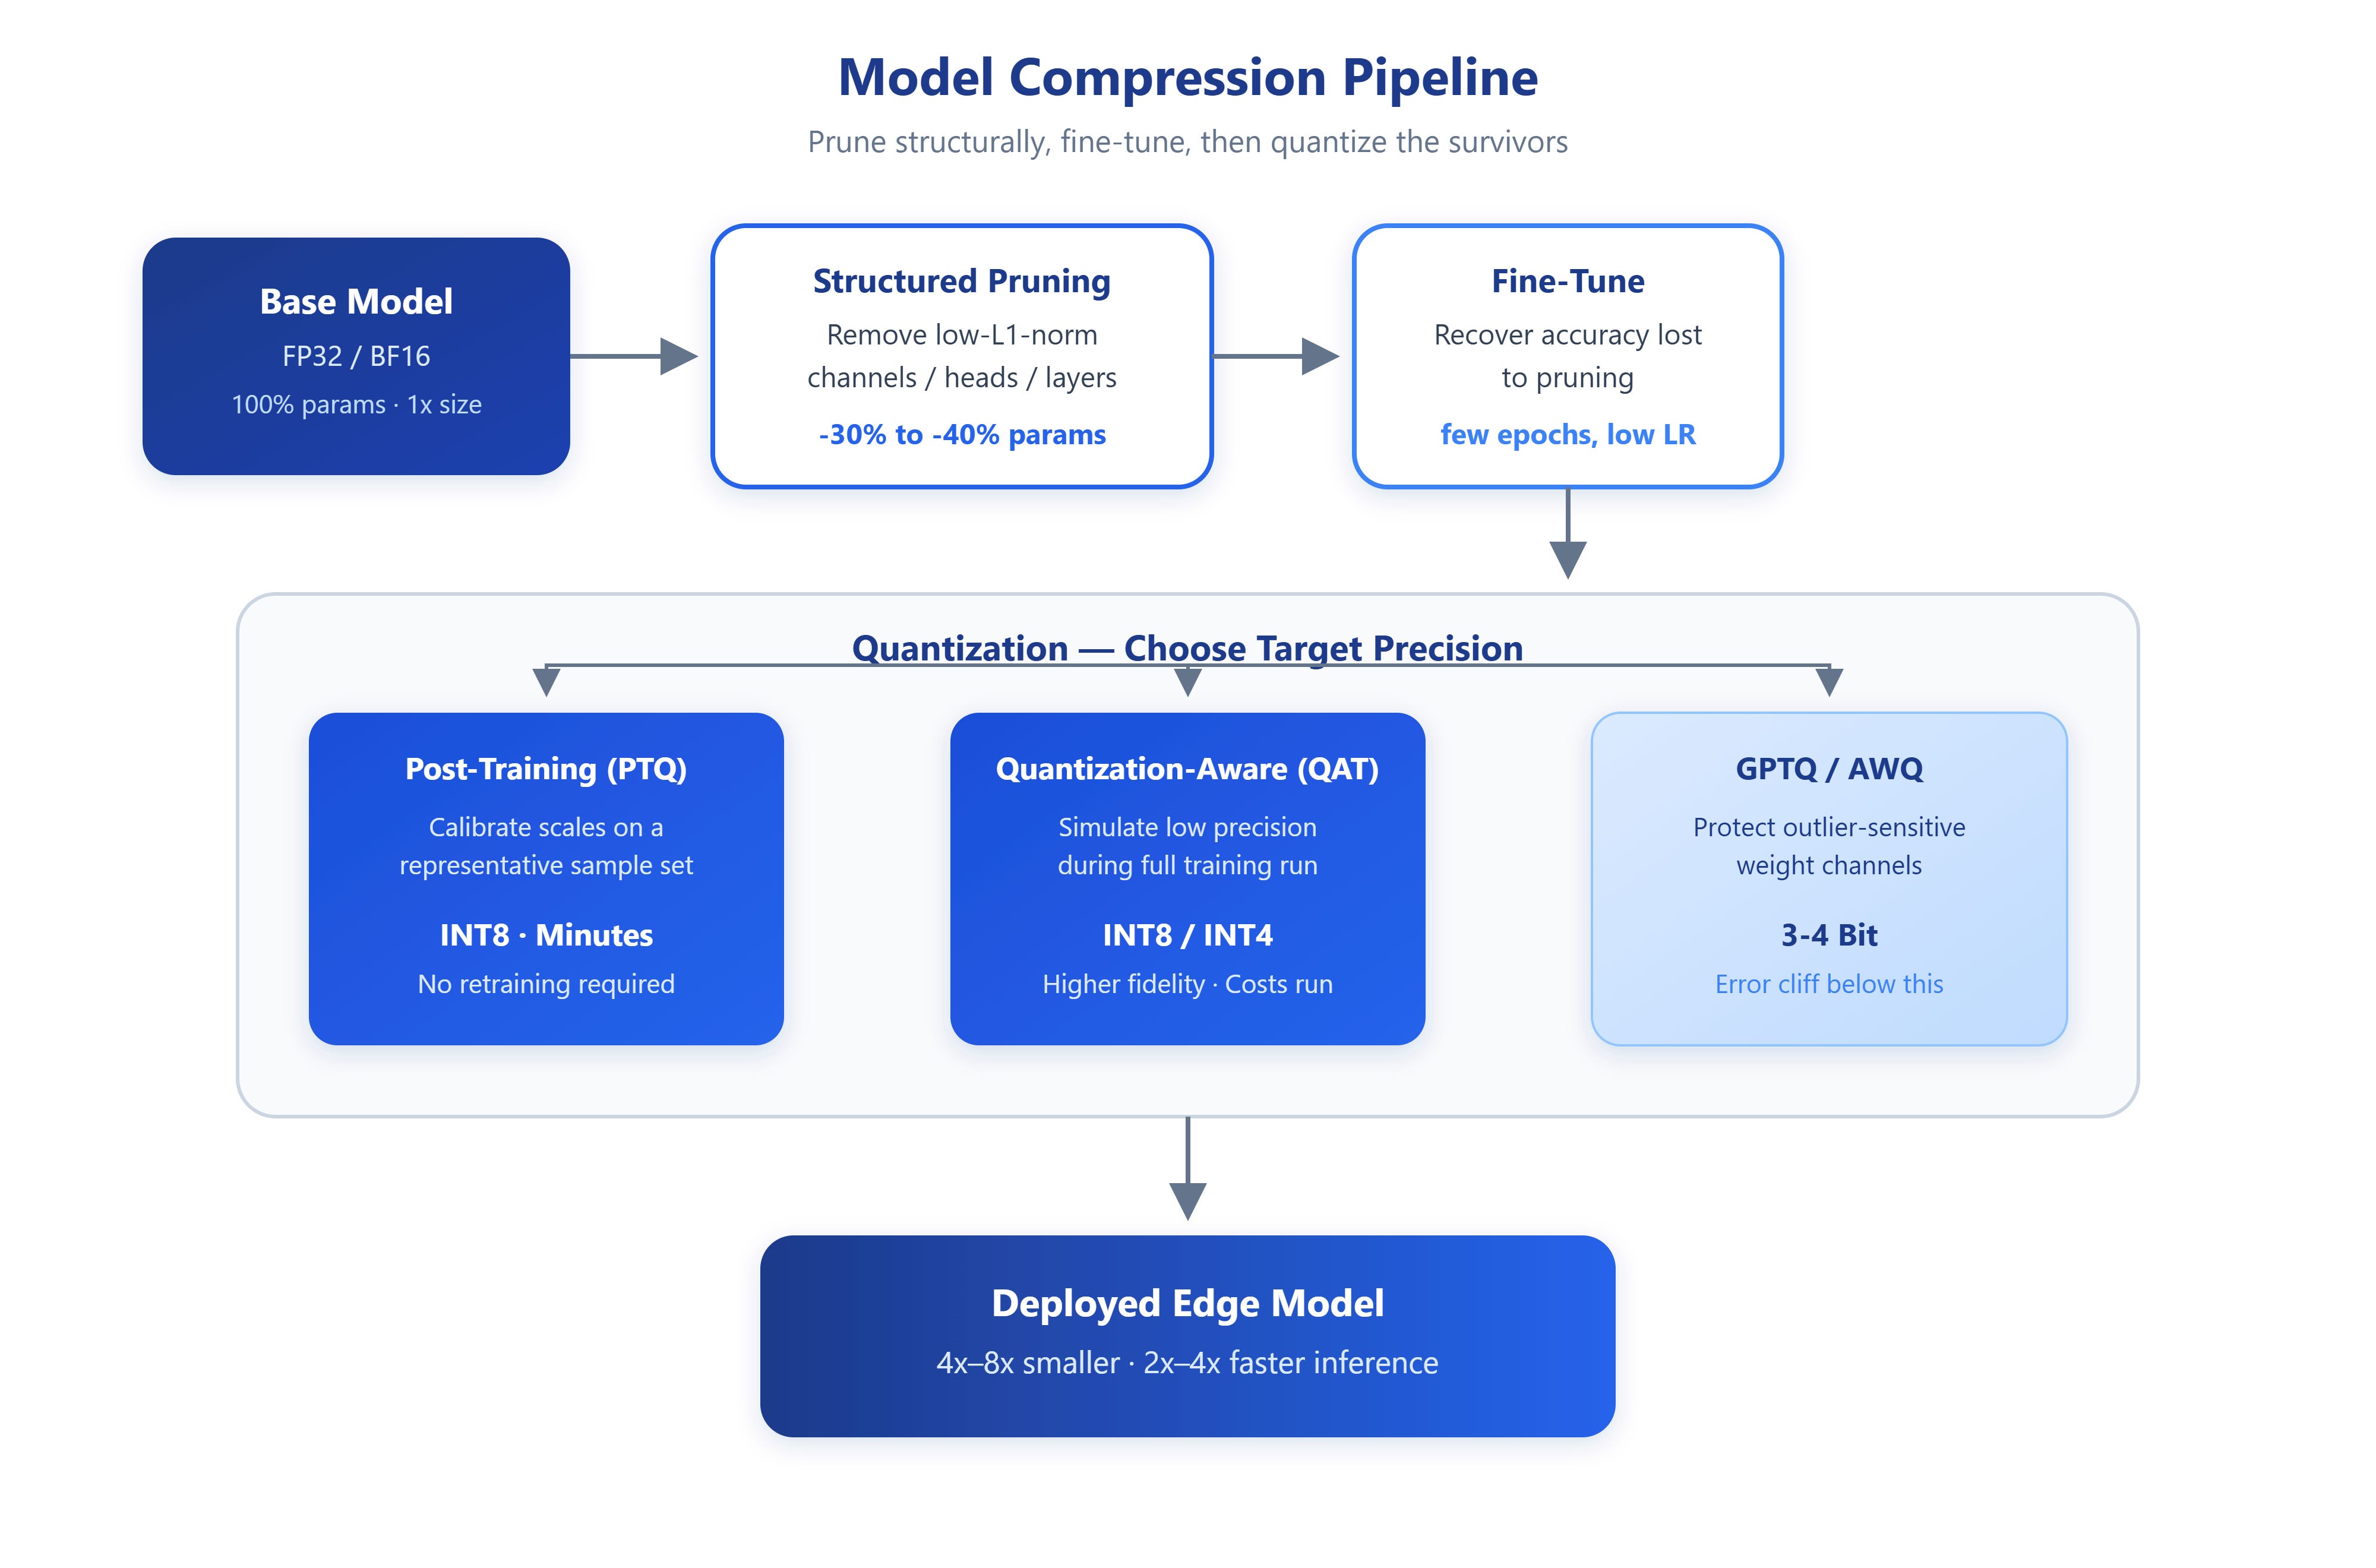
في التطبيقات الصناعية المتقدمة، لا يتم استخدام هاتين التقنيتين بشكل منفصل؛ بل يتم دمجهما في خط إنتاج موحد (Optimization Pipeline). يبدأ المهندسون بـ تقليم النموذج للتخلص من العصبونات الزائدة، يليه إعادة ضبط (Fine-tuning) لاستعادة الدقة، ومن ثم تطبيق التكميم على المعلمات المتبقية لتحويلها إلى دقة INT8.
يمكّن هذا التكامل الهجين من خفض حجم النماذج بنسبة قد تصل إلى 90% دون خسارة ملحوظة في الدقة. يفتح هذا الإنجاز آفاقاً واسعة لتشغيل تطبيقات الذكاء الاصطناعي الحساسة للوقت والمعقدة -مثل الرؤية الحاسوبية للسيارات ذاتية القيادة، والتنبؤ الطبي اللحظي في الأجهزة القابلة للارتداء، ومعالجة اللغات الطبيعية على الهواتف- بأمان كامل للبيانات وبأقل استهلاك ممكن للطاقة.